NVIDIA заявила про нові показники енергоефективності AI-інфраструктури
NVIDIA на AI Infra Summit представила результати для платформ Vera Rubin і DSX, зокрема до 3,7 раза вищу пропускну здатність Vera Rubin NVL72 проти GB300 NVL72 у попередніх даних MLPerf Inference v6.1. Lambda також повідомила про зростання продуктивності на ват на 23%.
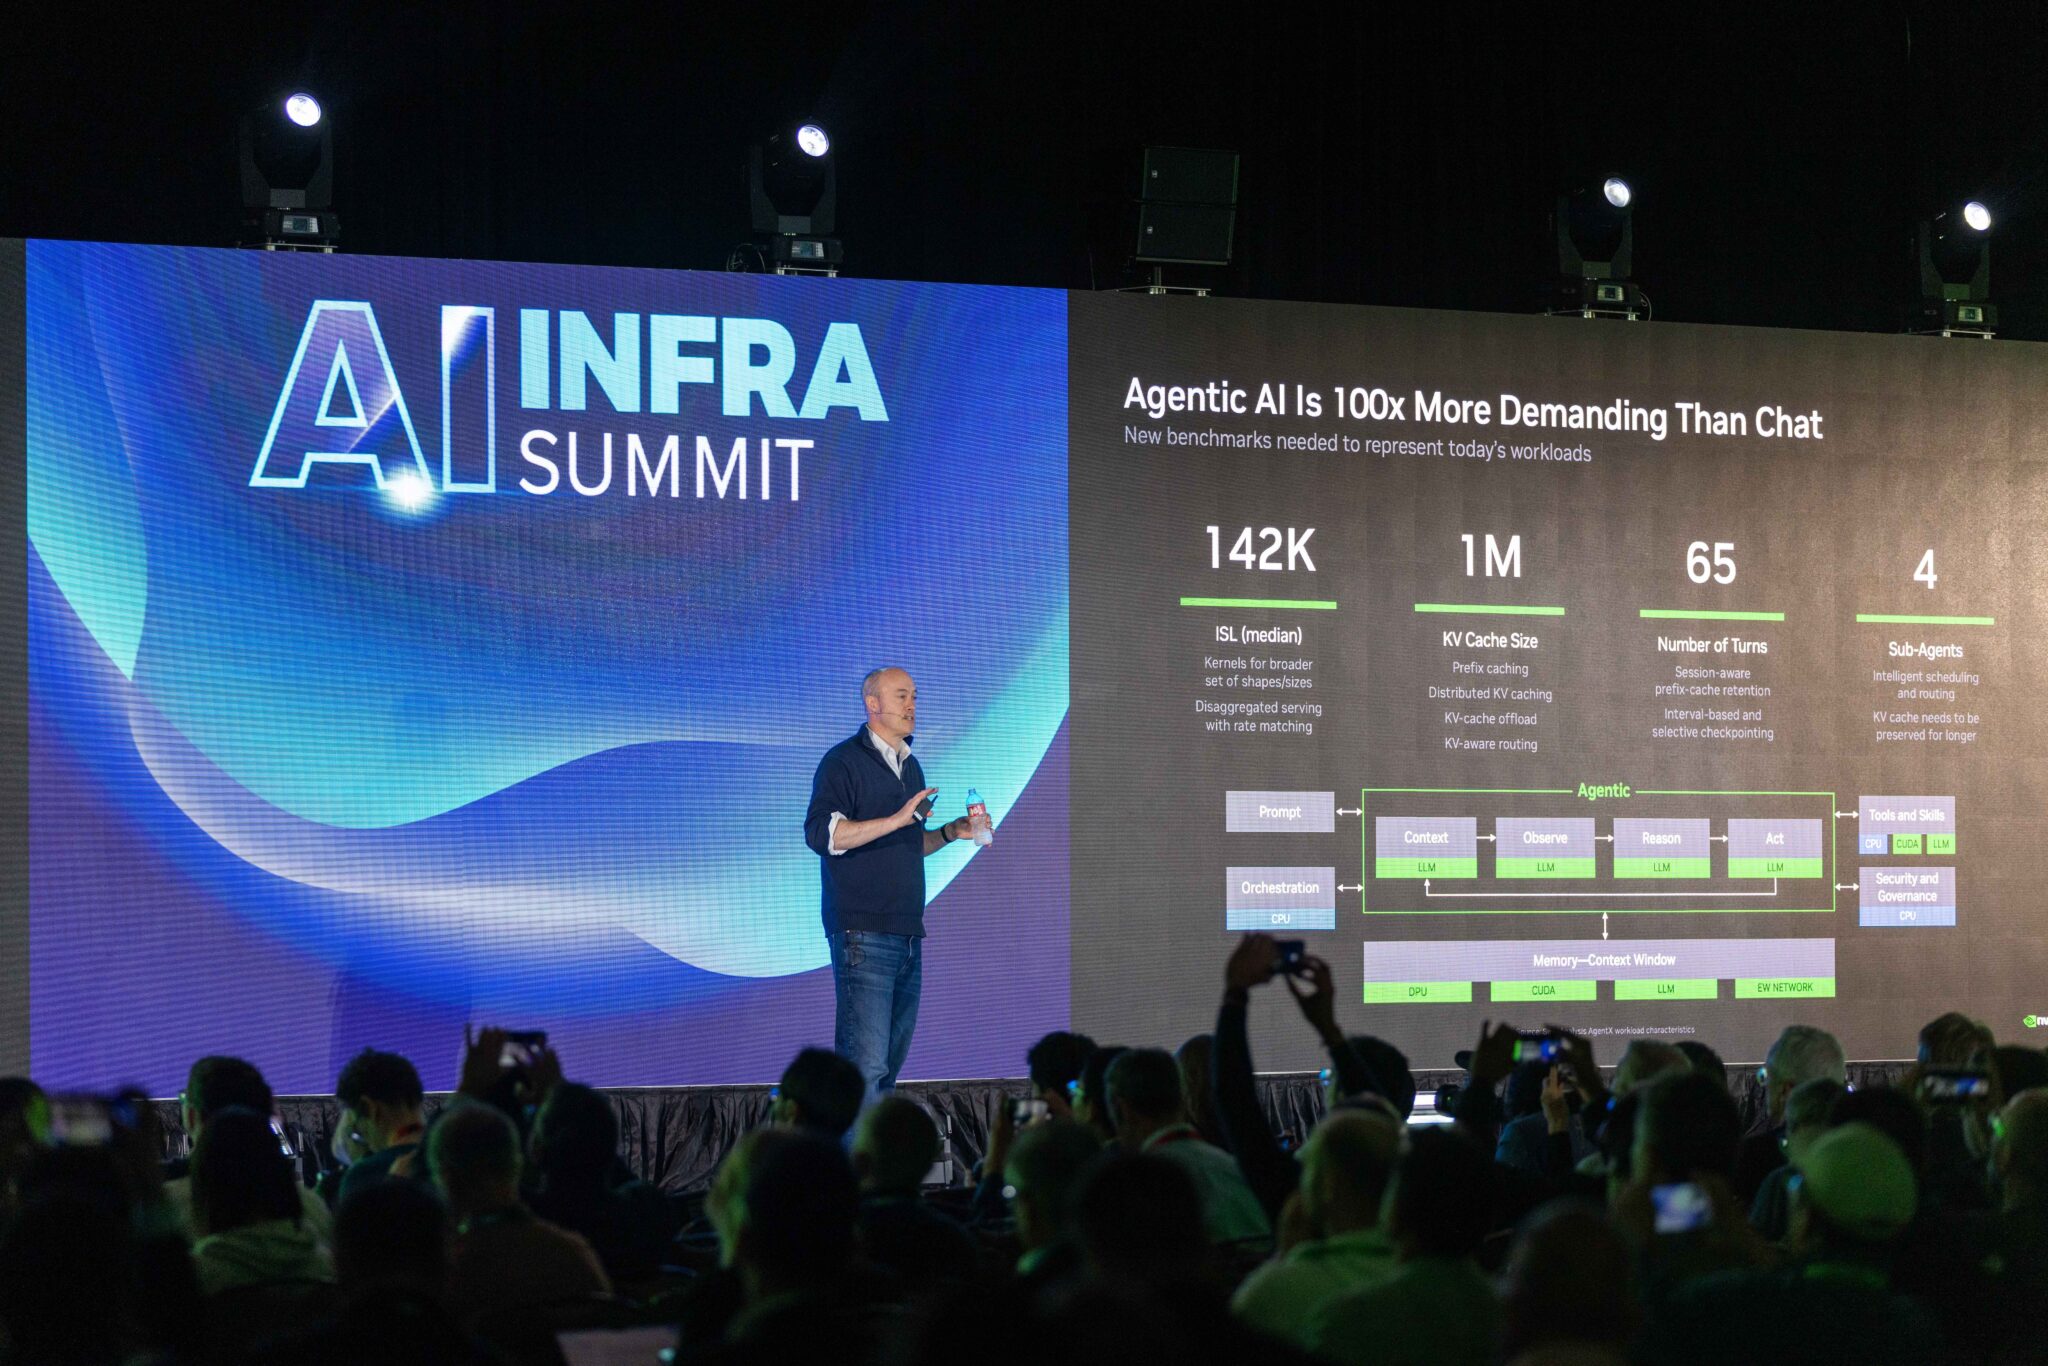
Image: blogs.nvidia.com · Author: NVIDIA Writers · source articleEditorial excerpt for news reporting
NVIDIA представила нові результати для AI-інфраструктури на AI Infra Summit у Санта-Кларі. Віцепрезидент компанії Ієн Бак розповів про платформи Vera Rubin і DSX, партнерські інтеграції та оптимізацію споживання енергії під час роботи AI-систем.
У попередніх результатах MLPerf Inference v6.1 система Vera Rubin NVL72 показала до 3,7 раза вищу пропускну здатність, ніж NVIDIA GB300 NVL72. Тестування MLPerf проходить у межах консорціуму MLCommons, а результати перевіряють перед публікацією.
На заході також повідомили, що Lambda підвищила продуктивність на ват на 23% за допомогою NVIDIA DSX MaxLPS. Компанія запустила 19 вузлів у бюджеті потужності, зазвичай розрахованому на 16 вузлів, і збільшила пропускну здатність кластера приблизно з 4 до 5 млн токенів за секунду.
Платформа Vera Rubin і результати MLPerf
У тесті з чотирма стійками GB300 NVL72, загалом на 288 GPU, масштабування досягло 99% ефективності. Окремо NVIDIA заявила, що програмні оптимізації у версії MLPerf Inference v6.1 дали до 1,6 раза вищу продуктивність проти версії 6.0.
NVIDIA описує свою інфраструктуру як повний стек, що охоплює системи Vera Rubin, програмне забезпечення Dynamo і NeMo, мережеві рішення NVLink, Spectrum-X Ethernet і ConnectX SuperNICs, а також BlueField для зберігання контексту та захисту інфраструктури.
DSX керує потужністю AI-фабрик
Emerald AI і NVIDIA разом із Silicon Valley Power продемонстрували програму гнучкого навантаження для AI-фабрик. Система відреагувала на сотні сигналів оператора мережі, зменшуючи навантаження без порушення роботи пріоритетних AI-задач.
DSX Flex може автоматично призупиняти низькопріоритетні завдання під час запитів на зниження споживання, а потім відновлювати їх. Сигнали можуть стосуватися обмеження навантаження, реагування на попит або цін на електроенергію.
Інші партнерства та показники
Amazon Annapurna Labs працює з NVIDIA над технологією кастомної пам’яті NVHBM. d-Matrix інтегрує NVLink Fusion із процесорами Vera та прискорювачами Raptor XPU для низьколатентного висновування, а Pinterest використовує Blackwell і Dynamo для розмовного пошуку зображень.
Для Vera Rubin NVL72 NVIDIA заявила про можливість розміщувати до 40% більше GPU в тому самому енергетичному бюджеті в окремих середовищах розгортання. У поєднанні з Groq 3 LPX компанія також заявила про до 35-кратну вищу пропускну здатність токенів на мегават порівняно з GB200 NVL72 для моделей із понад 2 трлн параметрів і довгим контекстом.
На навантаженні Qwen 3.8 27B із контекстом 100 тисяч токенів Groq 3 LPX показав 2529 вихідних токенів за секунду на користувача. За даними панелі SemiAnalysis AgentX, Vera Rubin NVL72 продемонструвала до 30 разів вищу пропускну здатність на мегават, ніж GB300 NVL72, на моделі DeepSeek V4 Pro.
Що ми знаємо
- Vera Rubin NVL72 показала до 3,7 раза вищу пропускну здатність, ніж GB300 NVL72, у попередніх результатах MLPerf Inference v6.1.
- Lambda збільшила продуктивність на ват на 23% завдяки DSX MaxLPS.
- Emerald AI і NVIDIA продемонстрували автоматичне зниження навантаження AI-фабрики у відповідь на сотні сигналів Silicon Valley Power.
- У тесті Qwen 3.8 27B Groq 3 LPX досягла 2529 вихідних токенів за секунду на користувача.
Що саме перевіряється
- Редакція перевіряє повідомлення про те, що vera Rubin NVL72 показала до 3,7 раза вищу пропускну здатність, ніж GB300 NVL72, у попередніх результатах MLPerf Inference v6.1.
- Для перевірки зіставляються матеріали NVIDIA Newsroom; другого незалежного підтвердження поки немає.
Переглянути джерела1
COMMUNITY
Обговорення
Увійдіть, щоб долучитися до обговорення.
Коментарів ще немає. Почніть обговорення.